 OmniDoc Documentextractie
PDF naar Markdown en JSON, gratis
Haal de koppen, alinea's, tabellen en afbeeldingen van een PDF, een scan of een Office-bestand in de volgorde en hiërarchie van het origineel, want Markdown en JSON kun je direct gebruiken.
Begin gratis met extraherenDesktop-app: geen paginalimietTot 501 pagina's per PDF en geen maandelijkse limiet; gratis taken wachten in een wachtrij. Voor langere bestanden of als je haast hebt, heeft de OmniDoc desktop-app geen paginalimiet en geen wachtrij.
Kies per taak
- PDF tot MarkdownKopjes, paragrafen en tabellen bij elkaar
- Gescand document OCRGescande PDF bestanden en afbeeldingen naar bewerkbare gestructureerde tekst
- PDF tabelextractieTabellen in Markdown tabellen en JSON
- Word, PowerPoint en Excel naar MarkdownDe structuur van Office-bestanden wordt direct gelezen
Hoe het werkt
Upload het bestand
Log in met een OmniDoc-account en zet het bestand op de pagina.
Begin met de extractie
PDF bestanden, scans en afbeeldingen ondergaan lay-outanalyse, tekstherkenning en tabelherkenning; Office-bestanden, e-books en webpagina's worden direct geanalyseerd.
Download het resultaat
Download een ZIP-bestand met Markdown, JSON en de afbeeldingen. De baan draait op de achtergrond, dus je kunt de pagina sluiten.
Wat het resultaat blijft
Kopniveaus
Hoofdstukken, paragrafen en lijsten behouden de hiërarchie van het origineel; in Markdown zijn de koppen #, ## enzovoort.
Tabelrijen en -kolommen
Tabellen verschijnen als Markdown-tabellen en gestructureerde data, niet als een reeks cijfers.
Scans werken ook
Gescande PDF-bestanden en afbeeldingen worden eerst herkend en vervolgens georganiseerd op hun lay-out.
Afbeeldingen afzonderlijk geëxporteerd
Foto's worden opgeslagen in de map images/, en hun posities worden aangegeven in de Markdown en JSON.
Wat staat er in het ZIP-bestand
document.md | De volledige tekst als Markdown |
document.json | Gestructureerde gegevens in leesvolgorde |
images/ | De afbeeldingen van het document, afzonderlijk opgeslagen |
manifest.json | Een lijst met bestanden met basisinformatie |
Ondersteunde formaten
| Bestand | Hoe het wordt verwerkt |
|---|---|
| PDF, gescande PDF-, PNG-, JPG-, WEBP- en BMP-afbeeldingen | Lay-outanalyse, tekstherkenning (OCR) en tabelherkenning |
| Word documenten, PowerPoint presentaties, Excel werkbladen, CSV | De documentstructuur wordt direct gelezen |
| EPUB e-boeken, HTML pagina's | Hoofdstukken en hoofdtekst worden geparseerd |
| Markdown, TXT, SRT en ASS ondertitels | Omgezet naar dezelfde Markdown en JSON |
Voorbeeld
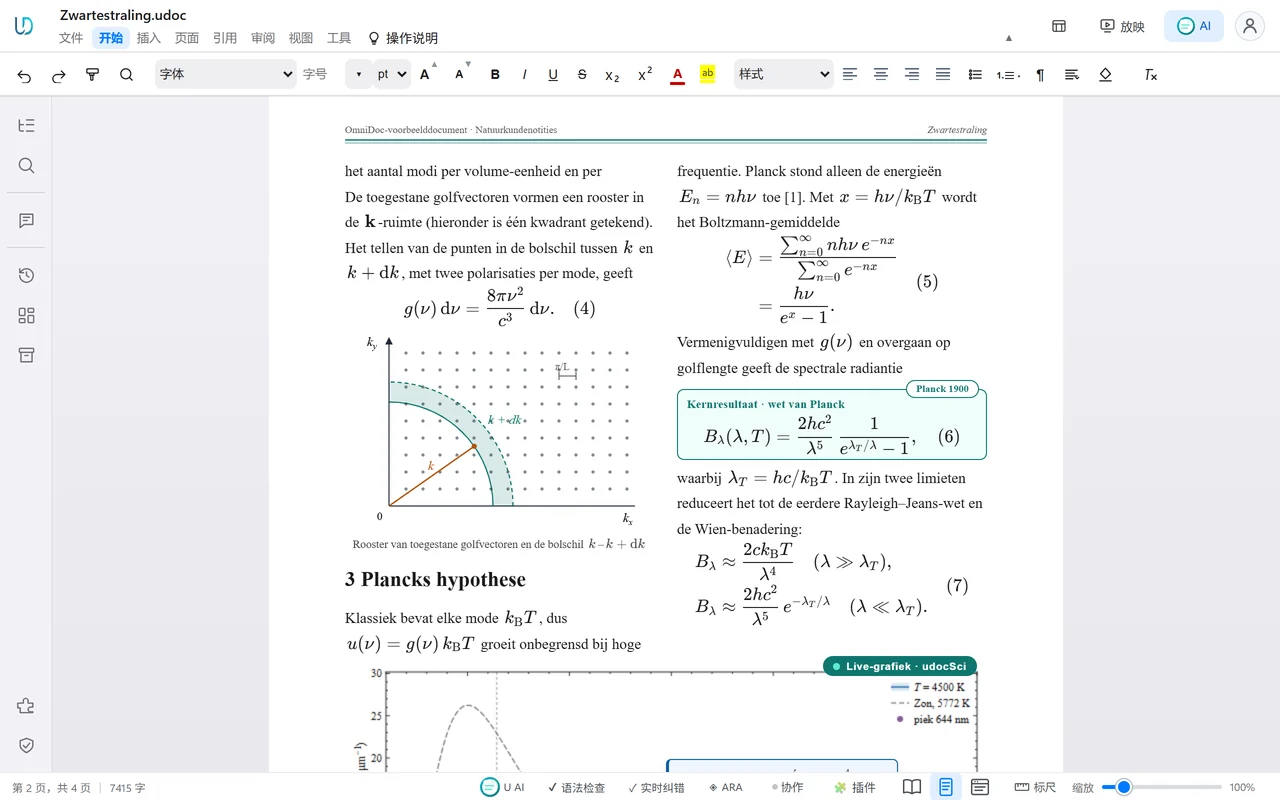
De OmniDoc desktop-app
De gratis desktop-app voor Windows, macOS en Linux opent, bewerkt en bewaart bestanden op uw eigen computer.
10.000 pagina's, en typen blijft vlot
Bewerk een document van meer dan 10.000 pagina's net zo makkelijk als een kort: elke toetsaanslag staat in ongeveer 9 ms opgemaakt en elke pagina is in ongeveer 3 ms bereikt.
100% ondersteuning voor klassieke Office XML
.docx-, .xlsx- en .pptx-bestanden openen en opslaan rechtstreeks en blijven standaard Office-bestanden; formules, grafieken en draaitabellen blijven werken.
De nieuwe Chinese standaardformaten
Open en bewerk OFD (GB/T 33190) en zet het om van en naar PDF; literatuurverwijzingen volgens GB/T 7714—2015, een scriptiesjabloon volgens GB/T 7713.1 en de nummering voor overheidsdocumenten 一、(一)1.(1)① zijn ingebouwd.
Vragen
Hoe verschilt dit van het kopiëren van de tekst?
Kopiëren geeft je platte tekst. Extractie houdt de koppen, alinea's, tabellen en afbeeldingen en hoe ze zich hiermee verhouden, als gestructureerde data die een programma kan gebruiken.
Waar kan ik het resultaat voor gebruiken?
Markdown gebruikt notities, kennisbanken en documentatiesites; de JSON is in leesvolgorde en past bij databases, AI-opvraging (RAG) en verdere verwerking door programma's.
Is de herkenning accuraat?
PDF-bestanden met een tekstlaag en Office-bestanden worden direct gelezen. Scans en afbeeldingen ondergaan tekstherkenning, dus controleer nummers en tabellen met het origineel.
Heb ik een account nodig?
Ja. Meld u aan met een OmniDoc-account; aanmelden is gratis. Alleen jij kunt de bestanden zien die je uploadt en hun resultaten.
Wat zijn de limieten van de gratis versie?
Tot 501 pagina's per PDF en geen maandelijkse limiet; gratis taken wachten in een wachtrij. Voor langere bestanden of als je haast hebt, heeft de OmniDoc desktop-app geen paginalimiet en geen wachtrij.
Moet ik iets installeren?
Nee, het draait in de browser. Voor lange bestanden, of als je haast hebt, gebruik dan de OmniDoc desktop-app voor Windows, macOS of Linux.
Probeer het nu
Tot 501 pagina's per PDF en geen maandelijkse limiet; gratis taken wachten in een wachtrij. Voor langere bestanden of als je haast hebt, heeft de OmniDoc desktop-app geen paginalimiet en geen wachtrij.
Begin gratis met extraherenDownload de desktop-app