 OmniDoc Extraction de documents
PDF en Markdown et JSON, gratuitement
Obtenez les titres, paragraphes, tableaux et images d'un PDF, d'un scan ou d'un fichier Office dans l'ordre et la hiérarchie de l'original, au format Markdown et JSON que vous pouvez utiliser immédiatement.
Commencez à extraire gratuitementApplication de bureau : aucune limite de pagesJusqu’à 501 pages par PDF sans plafond mensuel ; les tâches gratuites attendent dans une file d’attente. Pour les fichiers longs ou quand vous êtes pressé, l’application de bureau OmniDoc n’a ni limite de pages ni file d’attente.
Choisir par tâche
Comment ça fonctionne
Téléchargez le fichier
Connectez-vous avec un compte OmniDoc et déposez le fichier sur la page.
Démarrer l'extraction
Les fichiers PDF, les scans et les images passent par l’analyse de la mise en page, la reconnaissance du texte et la reconnaissance des tableaux ; les fichiers Office, les livres électroniques et les pages web sont analysés directement.
Téléchargez le résultat
Téléchargez un fichier ZIP avec Markdown, JSON et les images. Le travail s’exécute en arrière-plan, donc vous pouvez fermer la page.
Ce que garde le résultat
Niveaux de tête
Les chapitres, paragraphes et listes conservent la hiérarchie de l'original ; dans Markdown, les titres sont #, ## et ainsi de suite.
Lignes et colonnes de tableaux
Les tableaux deviennent des tableaux Markdown et des données structurées, pas une suite de chiffres.
Les scans fonctionnent aussi
Les fichiers et images PDF numérisés sont d'abord reconnus, puis organisés selon leur disposition.
Images exportées séparément
Les images sont enregistrées dans le dossier images/, et leur position est indiquée dans le Markdown et le JSON.
Ce qu’il y a dans le fichier ZIP
document.md | Le texte intégral sous forme de Markdown |
document.json | Données structurées dans l'ordre de lecture |
images/ | Les images du document, enregistrées séparément |
manifest.json | Une liste des fichiers avec des informations de base |
Formats pris en charge
| Fichier | Comment il est traité |
|---|---|
| PDF, images numérisées PDF, PNG, JPG, WEBP et BMP | Analyse de mise en page, reconnaissance de texte (OCR) et reconnaissance de tableaux |
| Word documents, PowerPoint présentations, Excel fiches, CSV | La structure du document se lit directement |
| EPUB livres électroniques, HTML pages | Les chapitres et le texte du corps sont analysés |
| Markdown, TXT, SRT et ASS sous-titres | Converti en le même Markdown et JSON |
Exemple
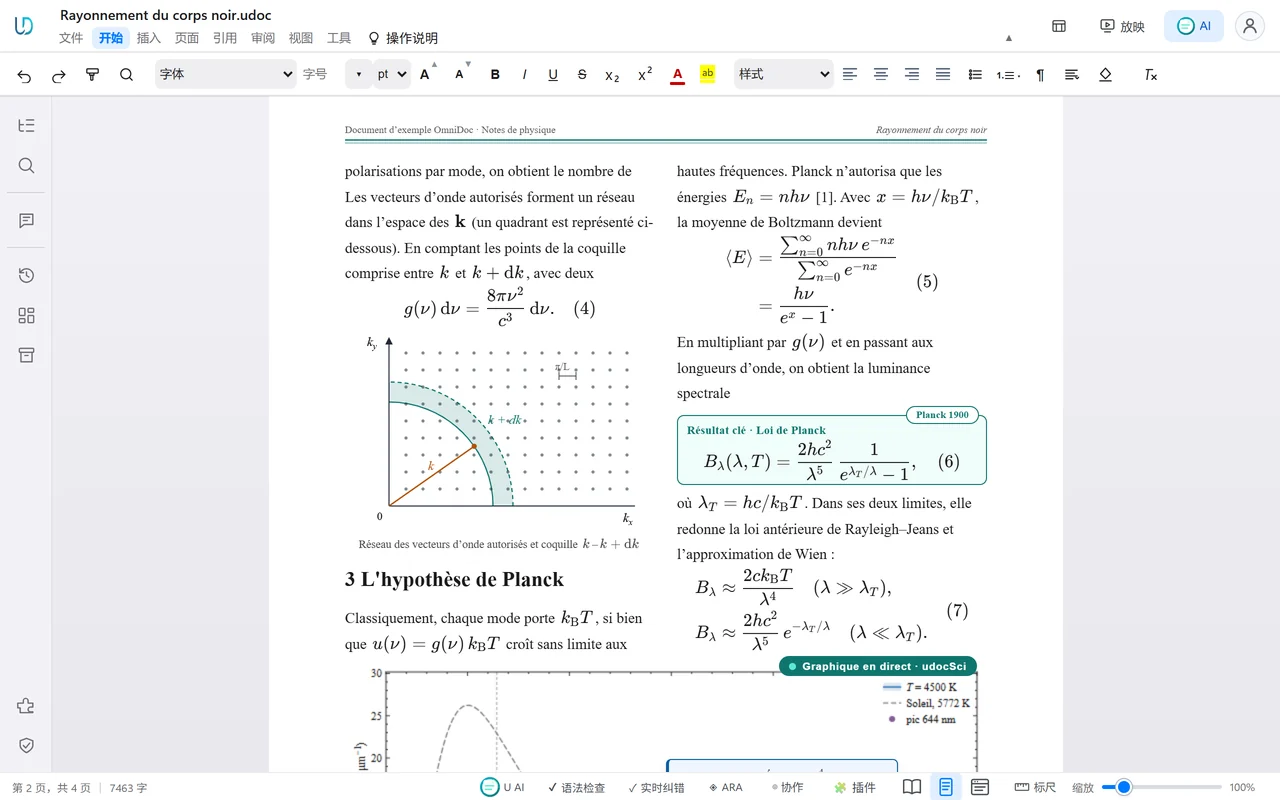
L'application de bureau OmniDoc
L’application gratuite de bureau pour Windows, macOS et Linux ouvre, édite et sauvegarde les fichiers sur votre propre ordinateur.
10 000 pages, et la saisie reste fluide
Modifiez un document de plus de 10 000 pages aussi facilement qu'un texte court : chaque frappe est mise en page en 9 ms environ, et l'on passe à n'importe quelle page en 3 ms environ.
Prise en charge à 100 % d'Office XML classique
Les fichiers .docx, .xlsx et .pptx s'ouvrent et s'enregistrent nativement et restent des fichiers Office standard ; formules, graphiques et tableaux croisés dynamiques continuent de fonctionner.
Les nouveaux formats normalisés chinois
Ouvrez et modifiez les fichiers OFD (GB/T 33190) et convertissez-les vers et depuis le PDF ; les références GB/T 7714—2015, un modèle de thèse GB/T 7713.1 et la numérotation des documents officiels 一、(一)1.(1)① sont intégrés.
Questions
En quoi est-ce différent de copier le texte ?
La copie vous donne du texte brut. L'extraction conserve les titres, les paragraphes, les tableaux et les images ainsi que leurs relations, sous forme de données structurées qu'un programme peut utiliser.
À quoi puis-je utiliser le résultat ?
Markdown convient aux notes, aux bases de connaissances et aux sites de documentation ; le JSON est dans l’ordre de lecture et convient aux bases de données, à la récupération IA (RAG) et au traitement ultérieur par les programmes.
La reconnaissance est-elle précise ?
Les fichiers PDF avec une couche texte et des fichiers Office sont lus directement. Les scans et les images passent par la reconnaissance de texte, donc vérifiez les numéros et les tableaux par rapport à l’original.
Ai-je besoin d'un compte ?
Oui. Connectez-vous avec un compte OmniDoc ; L’inscription est gratuite. Vous seul pouvez voir les fichiers que vous téléchargez et leurs résultats.
Quelles sont les limites de la version gratuite ?
Jusqu’à 501 pages par PDF sans plafond mensuel ; les tâches gratuites attendent dans une file d’attente. Pour les fichiers longs ou quand vous êtes pressé, l’application de bureau OmniDoc n’a ni limite de pages ni file d’attente.
Dois-je installer quelque chose ?
Non, il s’exécute dans le navigateur. Pour les fichiers longs, ou lorsque vous êtes pressé, utilisez l’application de bureau OmniDoc pour Windows, macOS ou Linux.
Essayez-le maintenant
Jusqu’à 501 pages par PDF sans plafond mensuel ; les tâches gratuites attendent dans une file d’attente. Pour les fichiers longs ou quand vous êtes pressé, l’application de bureau OmniDoc n’a ni limite de pages ni file d’attente.
Commencez à extraire gratuitementObtenez l'application de bureau