 OmniDoc Extrakce dokumentu
PDF do Markdown a JSON zdarma
Získejte nadpisy, odstavce, tabulky a obrázky PDF, scan nebo Office souboru v pořadí a hierarchii původního souboru, protože Markdown a JSON můžete použít hned.
Začněte extrahovat zdarmaDesktopová aplikace: bez limitu stránekAž 501 stran na PDF a žádný měsíční limit; bezplatné úlohy čekají ve frontě. Pro delší soubory nebo když spěcháte, desktopová aplikace OmniDoc nemá limit stránek ani frontu.
Jak to funguje
Nahrajte soubor
Přihlaste se s účtem OmniDoc a vložte soubor na stránku.
Začněte extrakci
PDF soubory, skeny a obrázky procházejí analýzou rozvržení, rozpoznáváním textu a rozpoznáváním tabulek; Kancelářské soubory, e-knihy a webové stránky jsou analyzovány přímo.
Stáhněte si výsledek
Stáhněte si soubor ZIP s Markdown, JSON a obrázky. Úloha běží na pozadí, takže stránku můžete zavřít.
Co výsledek udržuje
Úrovně nadpisů
Kapitoly, odstavce a seznamy zachovávají hierarchii originálu; v Markdown jsou nadpisy #, ## a tak dále.
Řádky a sloupce tabulky
Tabulky vycházejí jako Markdown tabulky a strukturovaná data, nikoli jako řada čísel.
Skenování funguje také
Nejprve se rozpoznávají naskenované soubory a obrázky PDF a poté jsou organizovány podle jejich rozložení.
Obrázky se exportují samostatně
Obrázky se ukládají do složky images/ a jejich pozice jsou označeny v Markdown a JSON.
Co je v ZIP souboru
document.md | Celý text jako Markdown |
document.json | Strukturovaná data v pořadí čtení |
images/ | Obrázky dokumentu, uložené zvlášť |
manifest.json | Seznam souborů se základními informacemi |
Podporované formáty
| Soubor | Jak je zpracováván |
|---|---|
| PDF, naskenované obrázky PDF, PNG, JPG, WEBP a BMP | Analýza rozvržení, rozpoznávání textu (OCR) a rozpoznávání tabulek |
| Word dokumenty, PowerPoint prezentace, Excel listy, CSV | Struktura dokumentu se čte přímo |
| EPUB e-knih, HTML stránek | Kapitoly a hlavní text jsou rozčleněny |
| Markdown, TXT, SRT a ASS titulky | Převedeno na stejné Markdown a JSON |
Příklad
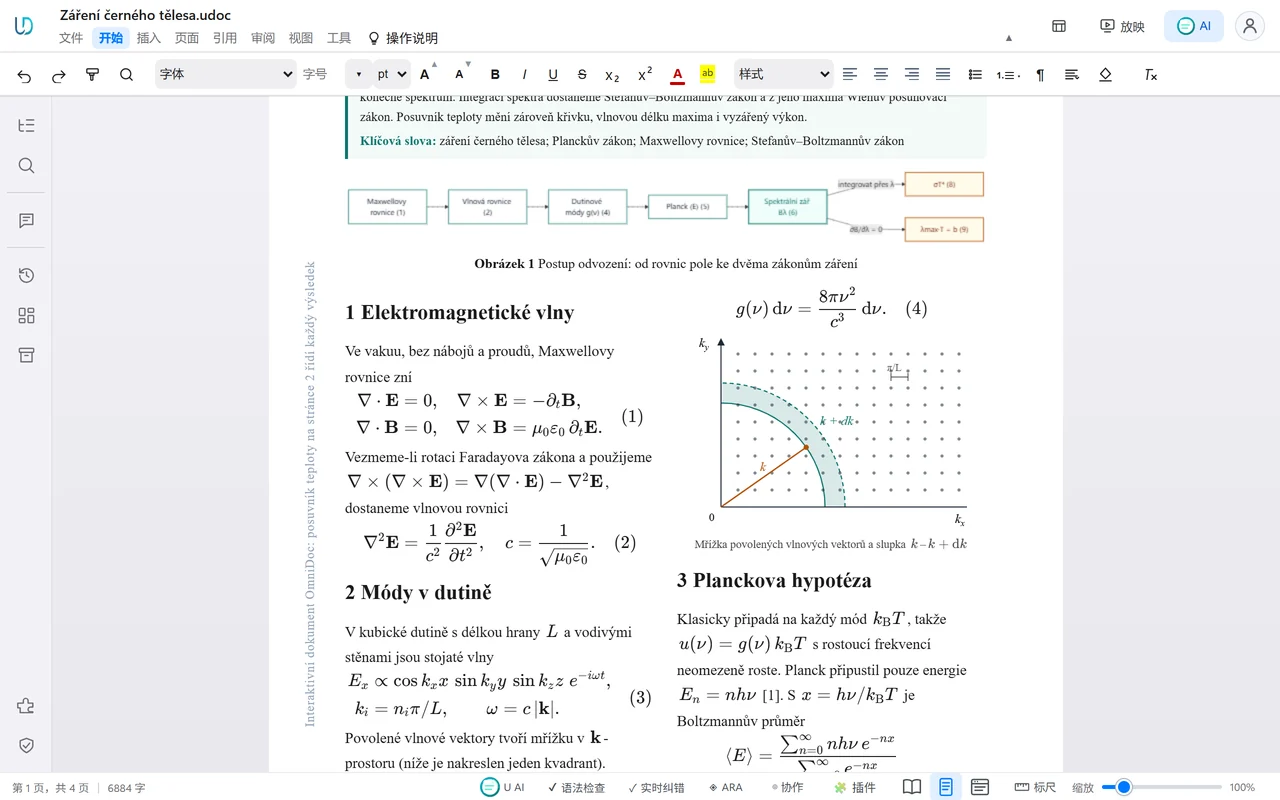
Desktopová aplikace OmniDoc
Bezplatná desktopová aplikace pro Windows, macOS a Linux otevírá, upravuje a ukládá soubory na vašem vlastním počítači.
10 000 stran a psaní pořád plyne
Dokument s více než 10 000 stranami upravíte stejně snadno jako krátký: každý stisk klávesy je vysázený zhruba za 9 ms a na libovolnou stranu se dostanete zhruba za 3 ms.
100% podpora klasického Office XML
Soubory .docx, .xlsx a .pptx se nativně otevírají i ukládají a zůstávají standardními soubory Office; vzorce, grafy a kontingenční tabulky fungují dál.
Nové čínské národní standardy
Otevírejte a upravujte OFD (GB/T 33190) a převádějte ho z PDF i do PDF; citace podle GB/T 7714—2015, šablona závěrečné práce podle GB/T 7713.1 a číslování úředních dokumentů 一、(一)1.(1)① jsou vestavěné.
Otázky
Jak se to liší od kopírování textu?
Kopírování vám dá obyčejný text. Extrakce uchovává nadpisy, odstavce, tabulky a obrázky a jejich vztahy jako strukturovaná data, která může program využívat.
K čemu mohu výsledek použít?
Markdown vyhovuje poznámkám, znalostním bázím a dokumentačním webům; JSON je v pořadí čtení a vyhovuje databázím, AI vyhledávání (RAG) a dalšímu zpracování programy.
Je rozpoznání přesné?
Soubory PDF s textovou vrstvou a soubory Office se čtou přímo. Skenování a obrázky procházejí rozpoznáváním textu, takže čísla a tabulky porovnejte s originálem.
Potřebuji účet?
Ano. Přihlaste se pomocí účtu OmniDoc; registrace je zdarma. Soubory, které nahrajete, a jejich výsledky vidíte pouze vy.
Jaké jsou limity bezplatné verze?
Až 501 stran na PDF a žádný měsíční limit; bezplatné úlohy čekají ve frontě. Pro delší soubory nebo když spěcháte, desktopová aplikace OmniDoc nemá limit stránek ani frontu.
Musím něco instalovat?
Ne, běží v prohlížeči. Pro dlouhé soubory nebo když spěcháte, použijte desktopovou aplikaci OmniDoc pro Windows, macOS nebo Linux.
Zkuste to teď
Až 501 stran na PDF a žádný měsíční limit; bezplatné úlohy čekají ve frontě. Pro delší soubory nebo když spěcháte, desktopová aplikace OmniDoc nemá limit stránek ani frontu.
Začněte extrahovat zdarmaStaňte si desktopovou aplikaci