 OmniDoc 文档结构化提取
文档结构化提取
把 PDF、扫描件、Word、PPT、Excel 里的标题、段落、表格和图片按原文的层级取出来,得到可以直接用的 Markdown 和 JSON,而不是一大段没有结构的纯文本。
免费开始提取下载桌面客户端,不限页数单个 PDF 最多 21 页,每月不限次数;免费任务按提交顺序排队。文件页数多或着急用,可以下载 OmniDoc 桌面客户端,不限页数、不用排队。
三步完成
上传文件
登录 OmniDoc 账号,把文件拖进页面,或点「选择文件」。
开始提取
PDF、扫描件和图片经过版面分析、文字识别和表格识别;Word、PPT、Excel、电子书和网页直接解析文档结构。
下载结果
处理完成后下载 ZIP 压缩包,里面有 Markdown、JSON 和图片。任务在后台运行,关掉页面也不影响。
提取结果保留了什么
标题层级
章节标题、段落和列表按原文档的层级组织,Markdown 里就是 #、## 这样的标题。
表格的行和列
表格输出成 Markdown 表格和结构化数据,行列不会被打散成连续的文字。
扫描件也能处理
扫描版 PDF 和图片先做文字识别,再按版面整理结构。
图片单独导出
图片存进 images/ 目录,并在 Markdown 和 JSON 里标出位置。
下载的 ZIP 里有什么
document.md | Markdown 全文 |
document.json | 按阅读顺序排列的结构化数据 |
images/ | 文档里的图片,单独保存 |
manifest.json | 文件清单和基本信息 |
支持的文件格式
| 文件 | 处理方式 |
|---|---|
| PDF、扫描版 PDF、PNG、JPG、WEBP、BMP 图片 | 版面分析、文字识别(OCR)和表格识别 |
| Word、PowerPoint、Excel、CSV | 直接解析文档结构 |
| EPUB 电子书、HTML 网页 | 解析章节和正文结构 |
| Markdown、TXT、SRT、ASS 字幕 | 整理为统一的 Markdown 和 JSON |
提取效果
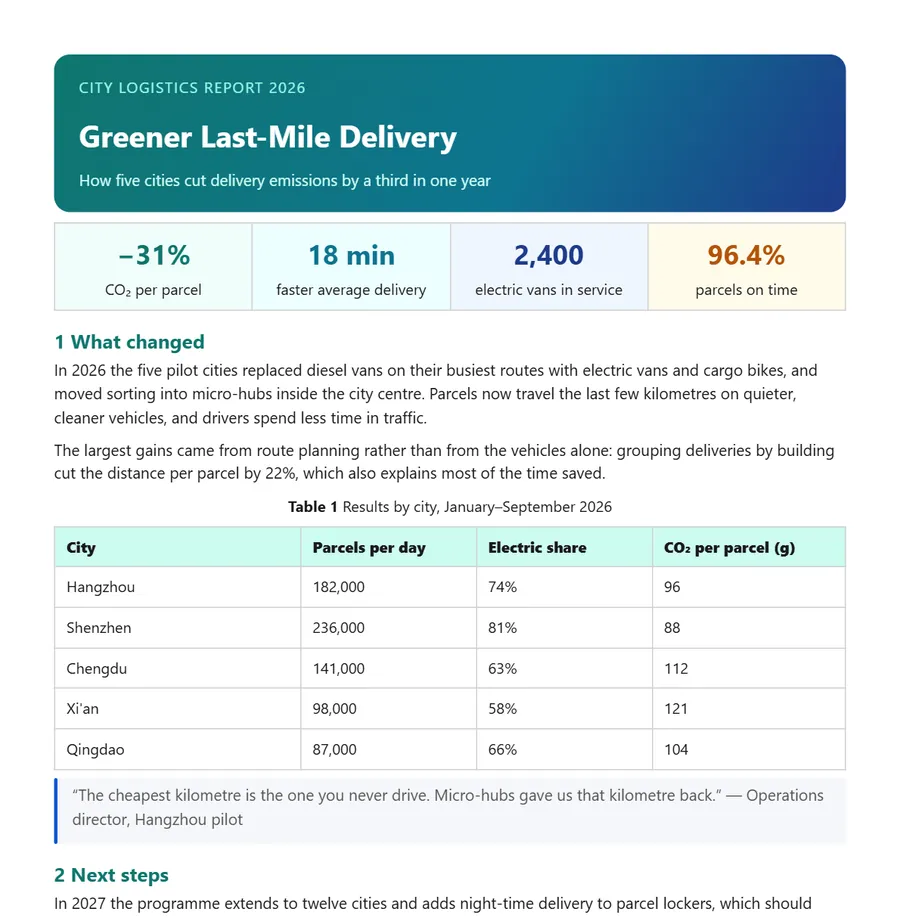
# Greener Last-Mile Delivery
How five cities cut delivery emissions by a third in one year

## 1 What changed
In 2026 the five pilot cities replaced diesel vans on their busiest routes with electric vans and cargo bikes, …

**Table 1** Results by city, January–September 2026
| City | Parcels per day | Electric share | CO₂ per parcel (g) |
|---|---|---|---|
| Hangzhou | 182,000 | 74% | 96 |
| Shenzhen | 236,000 | 81% | 88 |
| Chengdu | 141,000 | 63% | 112 |
常见问题
结构化提取和直接复制文字有什么区别?
直接复制只能得到一段文字。结构化提取会保留标题层级、段落、表格和图片之间的关系,得到的是能被程序读取的结构化数据。
提取结果可以用来做什么?
Markdown 适合放进笔记、知识库和文档站;JSON 按阅读顺序排列,适合导入数据库、给 AI 做检索(RAG)或继续用程序处理。
识别准确吗?
带文字层的 PDF 和 Office 文件直接读取原文。扫描件和图片经过文字识别,请和原文核对,尤其是数字和表格。
需要登录吗?
需要。用 OmniDoc 账号登录即可,注册免费。上传的文件和处理结果只有你自己能看到。
免费版有哪些限制?
单个 PDF 最多 21 页,每月不限次数;免费任务按提交顺序排队。文件页数多或着急用,可以下载 OmniDoc 桌面客户端,不限页数、不用排队。
需要安装软件吗?
不需要,在浏览器里就能用。页数多或者着急时,可以用 OmniDoc 桌面客户端(Windows、macOS、Linux)。
文件扩展名和实际格式不一致怎么办?
系统按文件内容识别真实格式,例如实际是 Word 的 .pdf 文件会按 .docx 处理。旧版 .doc、.xls、.ppt 请先另存为 .docx、.xlsx、.pptx。