 OmniDoc ഡോക്യുമെൻ്റ് എക്സ്ട്രാക്ഷൻ
PDF-ൽ നിന്ന് Markdown, JSON ആക്കി, സൗജന്യമായി
Markdown, JSON എന്നിവ നിങ്ങൾക്ക് ഉടനടി ഉപയോഗിക്കാൻ കഴിയുന്ന PDF, ഒരു സ്കാൻ അല്ലെങ്കിൽ ഒരു ഓഫീസ് ഫയൽ എന്നിവയുടെ തലക്കെട്ടുകൾ, ഖണ്ഡികകൾ, പട്ടികകൾ, ചിത്രങ്ങൾ എന്നിവ നേടുക.
സൗജന്യമായി എക്സ്ട്രാക്റ്റിംഗ് ആരംഭിക്കുകഡെസ്ക്ടോപ്പ് ആപ്പ്: പേജ് പരിധിയില്ലഓരോ PDF-നും 501 പേജുകൾ വരെ, പ്രതിമാസ പരിധി ഇല്ല; സൗജന്യ ടാസ്കുകൾ ക്യൂവിൽ കാത്തിരിക്കും. ദൈർഘ്യമേറിയ ഫയലുകൾക്കോ നിങ്ങൾ തിരക്കിലായിരിക്കുമ്പോഴോ, OmniDoc ഡെസ്ക്ടോപ്പ് ആപ്പിന് പേജ് പരിധിയും ക്യൂവും ഇല്ല.
ടാസ്ക് അനുസരിച്ച് തിരഞ്ഞെടുക്കുക
- PDF മുതൽ Markdown വരെതലക്കെട്ടുകൾ, ഖണ്ഡികകൾ, പട്ടികകൾ എന്നിവ ഒരുമിച്ച്
- സ്കാൻ ചെയ്ത ഡോക്യുമെന്റ് OCRPDF ഫയലുകളും ചിത്രങ്ങളും എഡിറ്റുചെയ്യാവുന്ന ഘടനാപരമായ വാചകത്തിലേക്ക് സ്കാൻ ചെയ്തു
- PDF പട്ടിക വേർതിരിച്ചെടുക്കൽMarkdown പട്ടികകളിലേക്കും JSON ലേക്കും പട്ടികകൾ
- Word, PowerPoint, Excel മുതൽ Markdown വരെഓഫീസ് ഫയലുകളുടെ ഘടന നേരിട്ട് വായിക്കുന്നു
ഇത് എങ്ങനെ പ്രവർത്തിക്കുന്നു
ഫയൽ അപ്ലോഡ് ചെയ്യുക
ഒരു OmniDoc അക്കൗണ്ട് ഉപയോഗിച്ച് സൈൻ ഇൻ ചെയ്ത് പേജിൽ ഫയൽ ഡ്രോപ്പ് ചെയ്യുക.
വേർതിരിച്ചെടുക്കൽ ആരംഭിക്കുക
PDF ഫയലുകളും സ്കാനുകളും ചിത്രങ്ങളും ലേഔട്ട് വിശകലനം, ടെക്സ്റ്റ് തിരിച്ചറിയൽ, പട്ടിക തിരിച്ചറിയൽ എന്നിവയിലൂടെ കടന്നുപോകുന്നു; ഓഫീസ് ഫയലുകൾ, ഇ-ബുക്കുകൾ, വെബ് പേജുകൾ എന്നിവ നേരിട്ട് പാഴ്സ് ചെയ്യുന്നു.
ഫലം ഡൗൺലോഡ് ചെയ്യുക
Markdown, JSON എന്നിവയും ചിത്രങ്ങളും ഉള്ള ഒരു ZIP ഫയൽ ഡൗൺലോഡ് ചെയ്യുക. ജോലി പശ്ചാത്തലത്തിൽ പ്രവർത്തിക്കുന്നു, അതിനാൽ നിങ്ങൾക്ക് പേജ് അടയ്ക്കാം.
ഫലം എന്താണ് നിലനിർത്തുന്നത്
തലക്കെട്ട് ലെവലുകൾ
അധ്യായങ്ങളും ഖണ്ഡികകളും ലിസ്റ്റുകളും ഒറിജിനലിൻ്റെ ശ്രേണി നിലനിർത്തുന്നു; Markdown-ൽ തലക്കെട്ടുകൾ #, ## എന്നിങ്ങനെയാണ്.
പട്ടിക വരികളും നിരകളും
പട്ടികകൾ Markdown പട്ടികകളായും ഘടനാപരമായ ഡാറ്റയായും പുറത്തുവരുന്നു, അക്കങ്ങളുടെ റൺ ആയിട്ടല്ല.
സ്കാനുകളും പ്രവർത്തിക്കുന്നു
സ്കാൻ ചെയ്ത PDF ഫയലുകളും ചിത്രങ്ങളും ആദ്യം തിരിച്ചറിയുകയും പിന്നീട് അവയുടെ ലേഔട്ട് അനുസരിച്ച് ക്രമീകരിക്കുകയും ചെയ്യുന്നു.
ചിത്രങ്ങൾ പ്രത്യേകം കയറ്റുമതി ചെയ്തു
ചിത്രങ്ങൾ images/ ഫോൾഡറിൽ സംരക്ഷിക്കപ്പെടുന്നു, അവയുടെ സ്ഥാനങ്ങൾ Markdown, JSON എന്നിവയിൽ അടയാളപ്പെടുത്തിയിരിക്കുന്നു.
ZIP ഫയലിൽ എന്താണ് ഉള്ളത്
document.md | മുഴുവൻ വാചകം Markdown ആയി |
document.json | ഘടനാപരമായ ഡാറ്റ വായന ക്രമത്തിൽ |
images/ | ഡോക്യുമെൻ്റിൻ്റെ ചിത്രങ്ങൾ പ്രത്യേകം സംരക്ഷിച്ചിരിക്കുന്നു |
manifest.json | അടിസ്ഥാന വിവരങ്ങളുള്ള ഫയലുകളുടെ ഒരു ലിസ്റ്റ് |
പിന്തുണയ്ക്കുന്ന ഫോർമാറ്റുകൾ
| ഫയൽ | ഇത് എങ്ങനെയാണ് പ്രോസസ്സ് ചെയ്യുന്നത് |
|---|---|
| PDF, സ്കാൻ ചെയ്ത PDF, PNG, JPG, WEBP, BMP ചിത്രങ്ങൾ | ലേഔട്ട് വിശകലനം, ടെക്സ്റ്റ് തിരിച്ചറിയൽ (OCR), പട്ടിക തിരിച്ചറിയൽ |
| Word പ്രമാണങ്ങൾ, PowerPoint അവതരണങ്ങൾ, Excel ഷീറ്റുകൾ, CSV | ഡോക്യുമെൻ്റ് ഘടന നേരിട്ട് വായിക്കുന്നു |
| EPUB ഇ-ബുക്കുകൾ, HTML പേജുകൾ | അധ്യായങ്ങളും ബോഡി ടെക്സ്റ്റും പാഴ്സ് ചെയ്തു |
| Markdown, TXT, SRT, ASS എന്നീ സബ്ടൈറ്റിലുകൾ | അതേ Markdown, JSON എന്നിവയിലേക്ക് പരിവർത്തനം ചെയ്തു |
ഉദാഹരണം
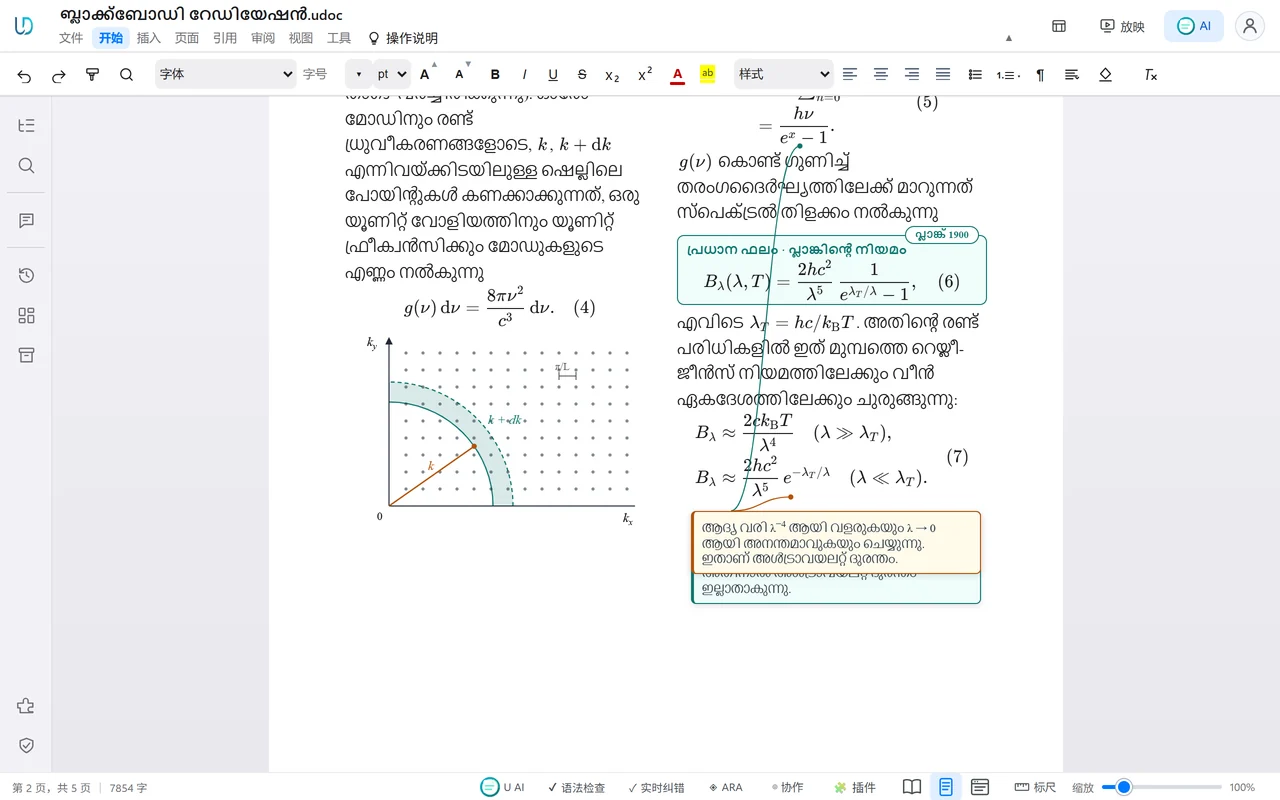
OmniDoc ഡെസ്ക്ടോപ്പ് ആപ്പ്
Windows, macOS, Linux എന്നിവയ്ക്കായുള്ള സൗജന്യ ഡെസ്ക്ടോപ്പ് ആപ്പ് നിങ്ങളുടെ സ്വന്തം കമ്പ്യൂട്ടറിൽ ഫയലുകൾ തുറക്കുകയും എഡിറ്റ് ചെയ്യുകയും സംരക്ഷിക്കുകയും ചെയ്യുന്നു.
10,000 പേജുള്ള രേഖയിലും ടൈപ്പിങ് തടസ്സമില്ലാതെ
10,000-ലധികം പേജുകളുള്ള രേഖയും ചെറിയ രേഖ പോലെ എളുപ്പത്തിൽ തിരുത്താം: ഓരോ കീ അമർത്തലും ഏകദേശം 9 മില്ലിസെക്കൻഡിൽ ലേഔട്ട് ചെയ്യപ്പെടുന്നു, ഏത് പേജിലേക്കും ഏകദേശം 3 മില്ലിസെക്കൻഡിൽ എത്താം.
പരമ്പരാഗത Office XML-ന് 100% പിന്തുണ
.docx, .xlsx, .pptx നേരിട്ട് തുറക്കുകയും സേവ് ചെയ്യുകയും ചെയ്യാം, അവ സ്റ്റാൻഡേർഡ് Office ഫയലുകളായിത്തന്നെ തുടരും; ഫോർമുലകളും ചാർട്ടുകളും പിവറ്റ് ടേബിളുകളും പഴയതുപോലെ പ്രവർത്തിക്കും.
ചൈനയുടെ പുതിയ ദേശീയ സ്റ്റാൻഡേർഡ് ഫോർമാറ്റുകൾ
OFD (GB/T 33190) തുറന്ന് എഡിറ്റ് ചെയ്യാം, PDF-ലേക്കും PDF-ൽ നിന്നും മാറ്റാം; GB/T 7714—2015 റഫറൻസുകൾ, GB/T 7713.1 തീസിസ് ടെംപ്ലേറ്റ്, ഔദ്യോഗിക രേഖകളുടെ നമ്പറിംഗ് 一、(一)1.(1)① എന്നിവ തയ്യാറാണ്.
ചോദ്യങ്ങൾ
വാചകം പകർത്തുന്നതിൽ നിന്ന് ഇത് എങ്ങനെ വ്യത്യാസപ്പെട്ടിരിക്കുന്നു?
പകർത്തുന്നത് നിങ്ങൾക്ക് പ്ലെയിൻ ടെക്സ്റ്റ് നൽകുന്നു. എക്സ്ട്രാക്ഷൻ തലക്കെട്ടുകൾ, ഖണ്ഡികകൾ, പട്ടികകൾ, ഇമേജുകൾ, അവ എങ്ങനെ ബന്ധപ്പെട്ടിരിക്കുന്നു എന്നിവ ഒരു പ്രോഗ്രാമിന് ഉപയോഗിക്കാൻ കഴിയുന്ന ഘടനാപരമായ ഡാറ്റയായി സൂക്ഷിക്കുന്നു.
എനിക്ക് ഫലം എന്തിനുവേണ്ടി ഉപയോഗിക്കാം?
Markdown കുറിപ്പുകൾ, വിജ്ഞാന അടിത്തറകൾ, ഡോക്യുമെന്റേഷൻ സൈറ്റുകൾ എന്നിവയ്ക്ക് അനുയോജ്യമാണ്; JSON വായനാ ക്രമത്തിലാണ്, ഡാറ്റാബേസ്, AI വീണ്ടെടുക്കൽ (RAG), പ്രോഗ്രാമുകൾ വഴി കൂടുതൽ പ്രോസസ്സിംഗ് എന്നിവയ്ക്ക് അനുയോജ്യമാണ്.
തിരിച്ചറിവ് കൃത്യമാണോ?
ടെക്സ്റ്റ് ലെയറും ഓഫീസ് ഫയലുകളും ഉള്ള PDF ഫയലുകൾ നേരിട്ട് വായിക്കപ്പെടുന്നു. സ്കാനുകളും ഇമേജുകളും ടെക്സ്റ്റ് തിരിച്ചറിയലിലൂടെ കടന്നുപോകുന്നു, അതിനാൽ ഒറിജിനലിനെതിരെ നമ്പറുകളും പട്ടികകളും പരിശോധിക്കുക.
എനിക്ക് ഒരു അക്കൗണ്ട് ആവശ്യമുണ്ടോ?
അതെ. ഒരു OmniDoc അക്കൗണ്ട് ഉപയോഗിച്ച് സൈൻ ഇൻ ചെയ്യുക; സൈൻ അപ്പ് സൗജന്യമാണ്. നിങ്ങൾ അപ് ലോഡ് ചെയ്യുന്ന ഫയലുകളും അവയുടെ ഫലങ്ങളും നിങ്ങൾക്ക് മാത്രമേ കാണാൻ കഴിയൂ.
സൗജന്യ പതിപ്പിന്റെ പരിധികൾ എന്തൊക്കെയാണ്?
ഓരോ PDF-നും 501 പേജുകൾ വരെ, പ്രതിമാസ പരിധി ഇല്ല; സൗജന്യ ടാസ്കുകൾ ക്യൂവിൽ കാത്തിരിക്കും. ദൈർഘ്യമേറിയ ഫയലുകൾക്കോ നിങ്ങൾ തിരക്കിലായിരിക്കുമ്പോഴോ, OmniDoc ഡെസ്ക്ടോപ്പ് ആപ്പിന് പേജ് പരിധിയും ക്യൂവും ഇല്ല.
ഞാൻ എന്തെങ്കിലും ഇൻസ്റ്റാൾ ചെയ്യേണ്ടതുണ്ടോ?
ഇല്ല, ഇത് ബ്രൗസറിൽ പ്രവർത്തിക്കുന്നു. ദൈർഘ്യമേറിയ ഫയലുകൾക്കായി, അല്ലെങ്കിൽ നിങ്ങൾ തിരക്കിലായിരിക്കുമ്പോൾ, Windows, macOS അല്ലെങ്കിൽ Linux എന്നതിനായി OmniDoc ഡെസ്ക്ടോപ്പ് ആപ്പ് ഉപയോഗിക്കുക.
ഇപ്പോൾ ശ്രമിക്കുക
ഓരോ PDF-നും 501 പേജുകൾ വരെ, പ്രതിമാസ പരിധി ഇല്ല; സൗജന്യ ടാസ്കുകൾ ക്യൂവിൽ കാത്തിരിക്കും. ദൈർഘ്യമേറിയ ഫയലുകൾക്കോ നിങ്ങൾ തിരക്കിലായിരിക്കുമ്പോഴോ, OmniDoc ഡെസ്ക്ടോപ്പ് ആപ്പിന് പേജ് പരിധിയും ക്യൂവും ഇല്ല.
സൗജന്യമായി എക്സ്ട്രാക്റ്റിംഗ് ആരംഭിക്കുകഡെസ്ക്ടോപ്പ് ആപ്പ് നേടുക