 OmniDoc文書抽出
 / PDF ファイルから表を抽出
PDF ファイルから表を抽出
PDF ファイルからテーブルを取り出し、コピー&ペースト後に 1 行に詰め込まれた数値としてではなく、Markdown テーブルおよび構造化データとしてヘッダー、行、列を保持した状態でスキャンします。
PDF をアップロードしてテーブルを抽出するデスクトップアプリ: ページ制限なしPDFあたり最大501ページまで、月間上限はありません。無料の処理は順番待ちになります。長いファイルや急いでいるときは、OmniDocデスクトップアプリにページ制限やキューはありません。
表の抽出方法
OmniDoc の表認識は、各表の領域、そのヘッダー、およびすべてのセルを検出し、それらを行ごと、列ごとに書き出します。スキャン内のテーブルは最初にテキストとして認識され、その後再構築されます。
テーブルはテキストと一緒に出てきます。document.md はMarkdownのテーブルがあり、document.jsonではすべてのテーブルが行と列の構造化データで、キャプションやテキストはその周囲に残されています。
例
仕組み
ファイルをアップロードする
OmniDocアカウントでサインインし、そのページにファイルを置いてください。
抽出を始めろ
PDF ファイル、スキャン、画像はレイアウト分析、テキスト認識、表認識を経ます。 Office ファイル、電子書籍、Web ページは直接解析されます。
結果をダウンロードしてください
Markdown、JSON、画像を含む ZIP ファイルをダウンロードします。ジョブはバックグラウンドで実行されるため、ページを閉じても問題ありません。
OmniDocデスクトップアプリ
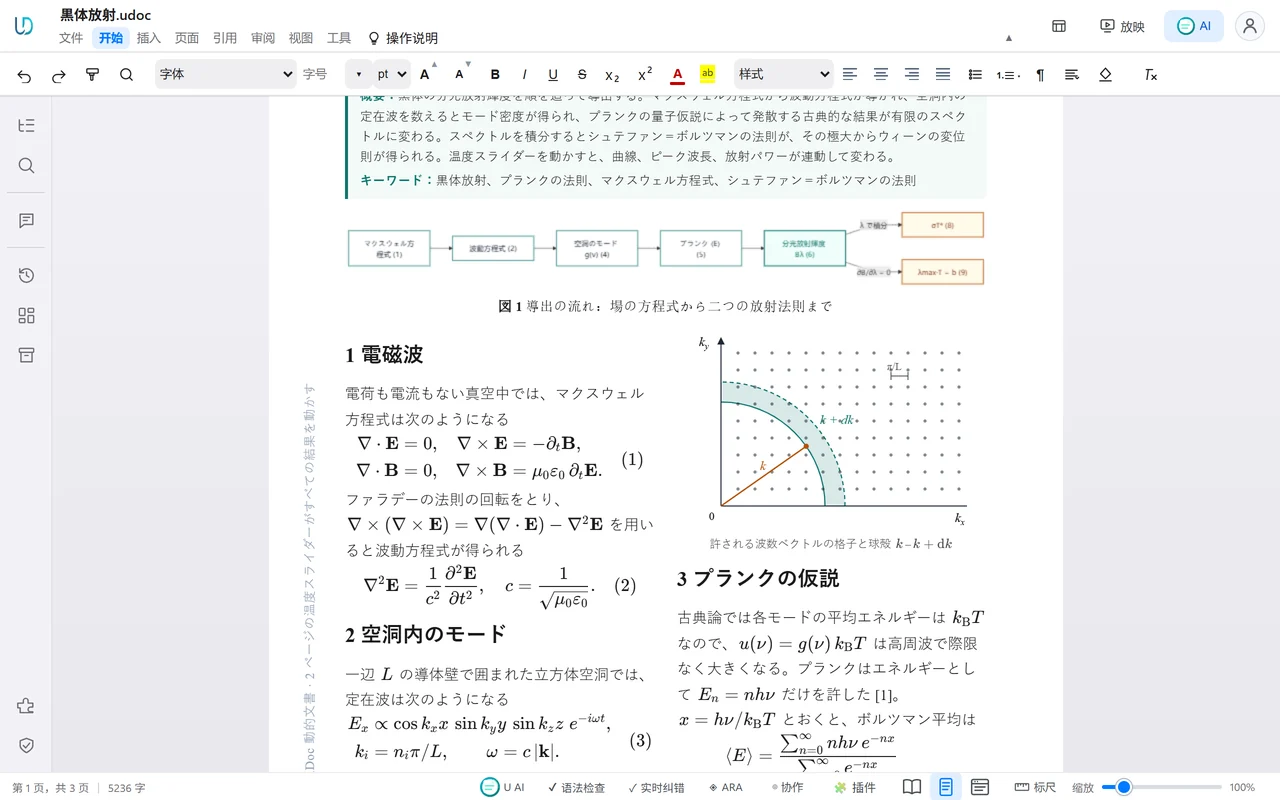
Windows、macOS、Linuxの無料デスクトップアプリは、自分のパソコン上でファイルを開いたり編集したり保存したりできます。
1万ページの文書でも、入力はサクサク
1万ページを超える長い文書も短い文書と同じように編集できます。1文字入力するごとに約 9 ミリ秒でレイアウトが確定し、どのページへも約 3 ミリ秒で移動できます。
従来の Office XML を 100% サポート
.docx・.xlsx・.pptx をネイティブに開いて保存し、保存後も標準の Office ファイルのまま。数式、グラフ、ピボットテーブルもそのまま動きます。
中国の新しい国家標準形式にそのまま対応
OFD(GB/T 33190)を開いて編集し、PDF と相互変換。GB/T 7714—2015 の参考文献、GB/T 7713.1 の学位論文テンプレート、公文の番号体系 一、(一)1.(1)① もすぐに使えます。
質問
結合されたセルは認識されますか?
一般的なマージされたヘッダーが認識されます。非常に複雑なテーブルを元のテーブルと照合します。
Excelにエクスポートできますか?
出力は今のところMarkdownとJSONです。JSON内のテーブルは行と列で整理されているため、スプレッドシートプログラムにインポートしたりスクリプトで変換したりできます。
アカウントは必要ですか?
はい。 OmniDoc アカウントでサインインします。サインアップは無料です。アップロードしたファイルとその結果を見ることができるのは自分だけです。
無料版の制限は何でしょうか?
PDFあたり最大501ページまで、月間上限はありません。無料の処理は順番待ちになります。長いファイルや急いでいるときは、OmniDocデスクトップアプリにページ制限やキューはありません。
今すぐ試してみて
PDFあたり最大501ページまで、月間上限はありません。無料の処理は順番待ちになります。長いファイルや急いでいるときは、OmniDocデスクトップアプリにページ制限やキューはありません。
PDF をアップロードしてテーブルを抽出するデスクトップアプリを入手する